Come funzionano i Sistemi di Visione AI
- Aggiornato: Agosto 2025
- Lettura: 8 minuti
- Tecnico
In questo articolo:
- Introduzione: Cos’è la Visione AI?
- I 5 Step di Funzionamento
- Deep Learning vs Machine Learning Tradizionale
- Come funzionano i CNN (Convolutional Neural Networks)
- Training del Modello: Come impara l’AI
- Metriche di Performance: Accuracy, Precision, Recall
- Performance nel Mondo Reale
- Limiti e Falsi Positivi
- Domande Frequenti
Introduzione: Cos’è la Visione AI?
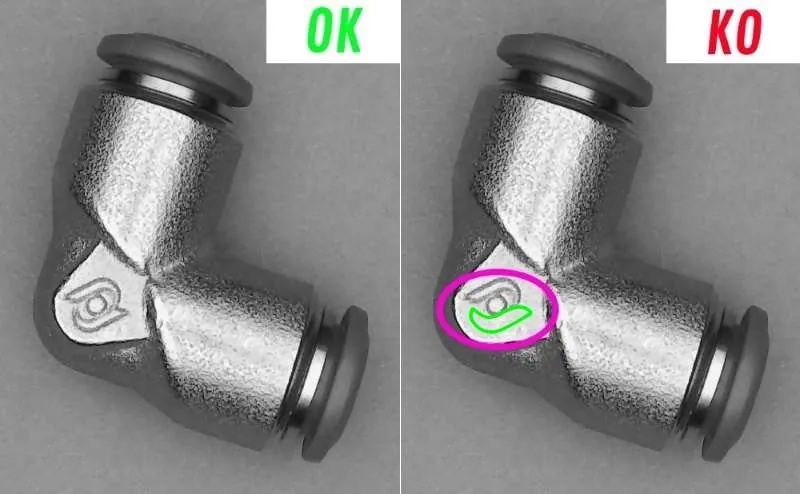
La visione artificiale AI (Computer Vision AI) è una branca dell’intelligenza artificiale che insegna ai computer a “vedere” e “interpretare” immagini nello stesso modo in cui lo fa l’occhio umano — ma con precisione e velocità sovrumane.
A differenza dei sistemi di visione tradizionali (che seguono regole rigide codificate manualmente), i sistemi di visione AI imparano dai dati. Vedono migliaia di immagini di prodotti, identificano pattern che gli umani non riescono a percepire, e migliorano continuamente nel tempo.
In termini semplici: Se un ispettore QC umano vede il 70% dei difetti perché si stanca, un sistema di visione AI ne vede il 99.8% perché non si stanca mai — e impara da ogni immagine che elabora.
I 5 Step di Funzionamento
Ecco il percorso che segue un’immagine dal momento in cui entra nel sistema fino a quando genera una decisione:
Step 1: Acquisizione dell’immagine
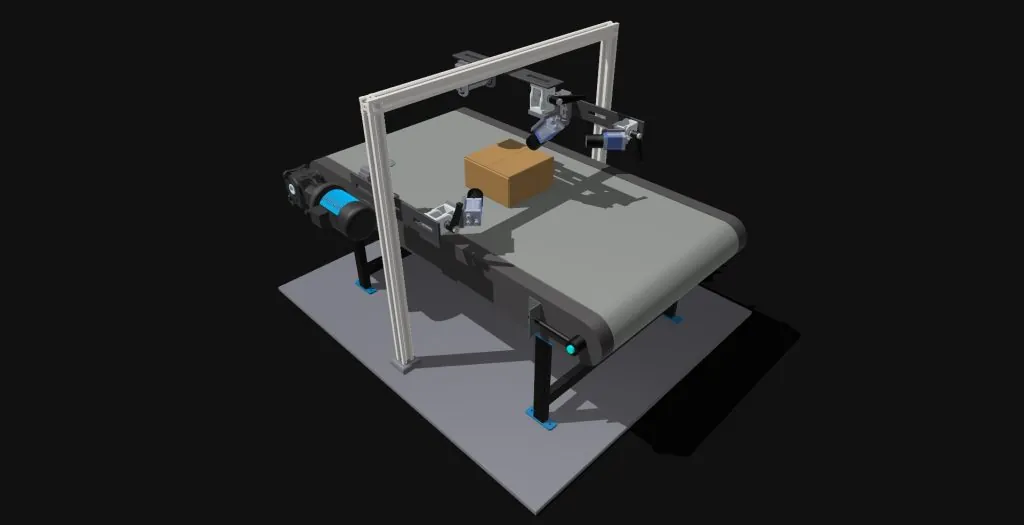
Una camera ad alta risoluzione (5-12 megapixel) cattura l’immagine del prodotto in tempo reale mentre passa sulla linea. La camera non è una telecamera semplice — è equipaggiata con:
- Sensore CMOS/CCD ad alta risoluzione (per catturare dettagli microscopici)
- Illuminazione multi-spettrale (LED controllati per eliminare ombre e riflessi)
- Ottica telecentric/macro (per garantire distorsione minima e precisione ±0.1mm)
- Velocità di cattura sincronizzata con il movimento del prodotto (millisecondi)
Step 2: Preprocessing (Pulizia dell’immagine)
L’immagine grezza contiene “rumore” — variazioni di illuminazione, riflessi, sporco sulla lente. Il preprocessing le rimuove:
- Normalizzazione contrasto
- Riduzione rumore (smoothing)
- Correzione illuminazione
- Estrazione bordi e feature rilevanti
Dopo il preprocessing, l’immagine è “pulita” e pronta per l’analisi.
Step 3: Feature Extraction (Deep Learning Detection)
Qui inizia il vero “cervello”: una rete neurale artificiale (CNN) analizza l’immagine in millisecondo, attraversando milioni di layer nascosti che cercano pattern.
INPUT IMAGE (1000x1000px) [CONV LAYER 1] – Rileva bordi semplici [CONV LAYER 2] – Rileva forme (cerchi, linee) [CONV LAYER 3] – Rileva texture (rugosità, pattern) [CONV LAYER 4-8] – Rileva “concetti” (graffi, bolle, deformazioni) [FULLY CONNECTED] – Prende la decisione finale OUTPUT: “DIFETTO RILEVATO” + Confidence: 96%
Ogni layer trasforma l’immagine, estraendo informazioni sempre più complesse. Il primo layer potrebbe riconoscere una linea; l’ottavo layer riconosce “questa linea è un graffio”.
Step 4: Classification & Decision
La rete neurale genera un confidence score (0-100%) per ogni possibile difetto:
- Graffio: 78%
- Bolla: 5%
- Deformazione: 2%
- Nessun difetto: 15%
Se il confidence per il difetto con score più alto supera la soglia (es: 80%), il sistema dice “DIFETTO RILEVATO”. Se no, “PRODOTTO OK”.
Step 5: Azione automatica e Tracciamento
Se rilevato un difetto:
- Rifiuto istantaneo: Valvola pneumatica a solenoid spinge il prodotto fuori dalla linea
- Alert visuale: Operatore vede notifica su schermo (location difetto, tipo, severity)
- Tracciamento: Database registra foto difetto, timestamp, numero lotto, posizione sulla linea
- Feedback al modello: Sistema raccoglie il dato per future sessioni di training
AI Vision: Real-time Defect Detection Video: Come funziona il rilevamento difetti in tempo reale
Deep Learning vs Machine Learning Tradizionale
C’è una differenza cruciale tra “Machine Learning tradizionale” e “Deep Learning”:
| Aspetto | Machine Learning Tradizionale | Deep Learning |
|---|---|---|
| Feature Engineering | Umano sceglie quale aspetto dell’immagine analizzare | La rete neurale scopre automaticamente |
| Esempio | “Cerca linee dritte” Umano codifica algoritmo | “Impara da 10.000 immagini” Rete scopre pattern |
| Flessibilità | Difficile adattarsi a nuovi tipi di difetti | Retrain semplice su nuovi dati |
| Accuratezza | 70-80% (dipende da feature scelta bene) | 99%+ (impara pattern complessi) |
| Cosa funziona meglio | Difetti ben definiti e prevedibili | Difetti vari e imprevisti |
Analogia: Machine Learning tradizionale è come insegnare a qualcuno una lista di regole (“Se vedi una linea dritta, è un graffio”). Deep Learning è come mostrare 10.000 foto di graffi e lasciare che il cervello impari autonomamente a riconoscerli.
Come funzionano i CNN (Convolutional Neural Networks)
Un CNN è un’architettura di rete neurale specialmente progettata per elaborare immagini. La parola “convolutional” si riferisce al modo in cui la rete analizza l’immagine:
Convolution: Uno Sguardo Focalizzato
IMMAGINE ORIGINALE (28×28 pixel) Un “filtro” piccolo (3×3 pixel) scorre sull’immagine: ┌─────────────────────┐ │ [X X X] X X X X X X │ │ [X X X] X X X X X X │ Il filtro guarda questi 9 pixel │ [X X X] X X X X X X │ e calcola un numero │ X X X X X X X X X X │ │ X X X X X X X X X X │ │ … │ └─────────────────────┘ Il filtro si muove, pixel per pixel: ┌─────────────────────┐ │ X [X X X] X X X X X │ │ X [X X X] X X X X X │ Adesso guarda questi 9 │ X [X X X] X X X X X │ │ X X X X X X X X X X │ │ … │ └─────────────────────┘ Risultato: Una “mappa di attivazione” (feature map) che mostra dove nel’immagine sono presenti i pattern che il filtro sta cercando.
I CNN hanno milioni di filtri diversi, ognuno che cerca un pattern specifico:
- Livello 1: Filtri che cercano “bordi” (pattern semplici)
- Livello 2: Filtri che cercano “forme” (combinazioni di bordi)
- Livello 3-8: Filtri che cercano “concetti” (un graffio è una forma curva scura)
La rete apprende automaticamente quali filtri sono utili durante il training.
 CNN Visualization: How Neural Networks See
Video: Come visualizzare cosa “vede” una rete neurale CNN
Training del Modello: Come impara l’AI
Un modello di deep learning non nasce “intelligente”. Deve imparare dai dati. Ecco come funziona il training:
Passo 1: Raccogliere dati
- 200-300 immagini di prodotti BUONI (no difetti)
- 50-100 immagini di prodotti DIFETTOSI (vari tipi di difetti)
- Ogni immagine etichettata: “OK” o “DIFETTO – Tipo: Graffio”
Passo 2: Dividere in training e validation
- 70% per il training (il modello impara)
- 30% per la validation (verifichiamo che funziona su dati mai visti prima)
Passo 3: Addestramento
Per ogni immagine di training:
LOOP: 1. Passa l’immagine attraverso la rete 2. Rete predice: “Difetto al 75%” 3. Controlla l’etichetta vera: “Difetto al 100%” 4. Calcola l’errore: 25% 5. Regola i pesi della rete per ridurre l’errore 6. Ripeti con la prossima immagine Dopo 1000 immagini: L’errore scende da 45% 15% 5% 2%
Passo 4: Validation
Testa il modello su immagini che non ha mai visto. Se funziona bene (95%+ accuratezza), il modello è pronto per la produzione.
Overfitting Risk: Se addestri troppo su gli stessi 200 dati, il modello “memorizza” quelle immagini specifiche anziché imparare il pattern generale. Per questo usiamo dati di validation diversi.
Metriche di Performance: Accuracy, Precision, Recall
Come misuriamo se un sistema di visione AI funziona bene? Non solo “accuratezza” — ci sono tre metriche fondamentali:
1. Accuracy (Accuratezza)
Percentuale di predizioni corrette su tutto il dataset.
Accuracy = (Corretti) / (Totali) = 980 / 1000 = 98% Interpretazione: “Su 1000 prodotti, il sistema ha scelto correttamente 980 volte”
2. Precision (Precisione)
Tra tutti i prodotti che il sistema dice “DIFETTO”, quanti sono veramente difettosi?
Precision = (Veri Positivi) / (Veri Positivi + Falsi Positivi) = 95 / (95 + 5) = 95% Interpretazione: “Quando il sistema dice ‘difetto’, è corretto il 95% delle volte” Cosa significa bassissima precision: Scarta molti prodotti buoni (falsi positivi) Costi alti di rework
3. Recall (Sensibilità)
Tra tutti i prodotti veramente difettosi, quanti il sistema riesce a catturare?
Recall = (Veri Positivi) / (Veri Positivi + Falsi Negativi) = 95 / (95 + 3) = 97% Interpretazione: “Su 98 prodotti veramente difettosi, il sistema ne cattura 95” Cosa significa bassissimo recall: Lasciano passare difetti Clienti ricevono prodotti cattivi
Il Trade-off Precision vs Recall
Aumentare uno significa spesso diminuire l’altro. Un sistema può:
- Alta Precision, Basso Recall: “Scarto solo quando sono SICURO” Scarti pochi buoni, ma lasciano passare difetti
- Basso Precision, Alto Recall: “Scarto al minimo sospetto” Catturano tutti i difetti, ma scarti molti buoni
Target Logirobotix: Precision 99% + Recall 99.5% = Catturiamo quasi tutti i difetti, scarti quasi nessun buono.
 Precision vs Recall explained
Video: Capire Precision e Recall nel contesto di qualità
Performance nel Mondo Reale
I numeri di laboratorio sono belli, ma cosa succede in fabbrica con condizioni reali?
Benchmark reali Logirobotix
| Scenario | Accuracy | Precision | Recall |
|---|---|---|---|
| Laboratorio (dati puliti) | 99.8% | 99.7% | 99.9% |
| Fabbrica reale (illuminazione variabile) | 98.5% | 98.2% | 98.8% |
| Prodotti con “aging” (usura nel tempo) | 97.2% | 96.9% | 97.5% |
| Dopo retraining (30 giorni di dati) | 99.1% | 98.9% | 99.2% |
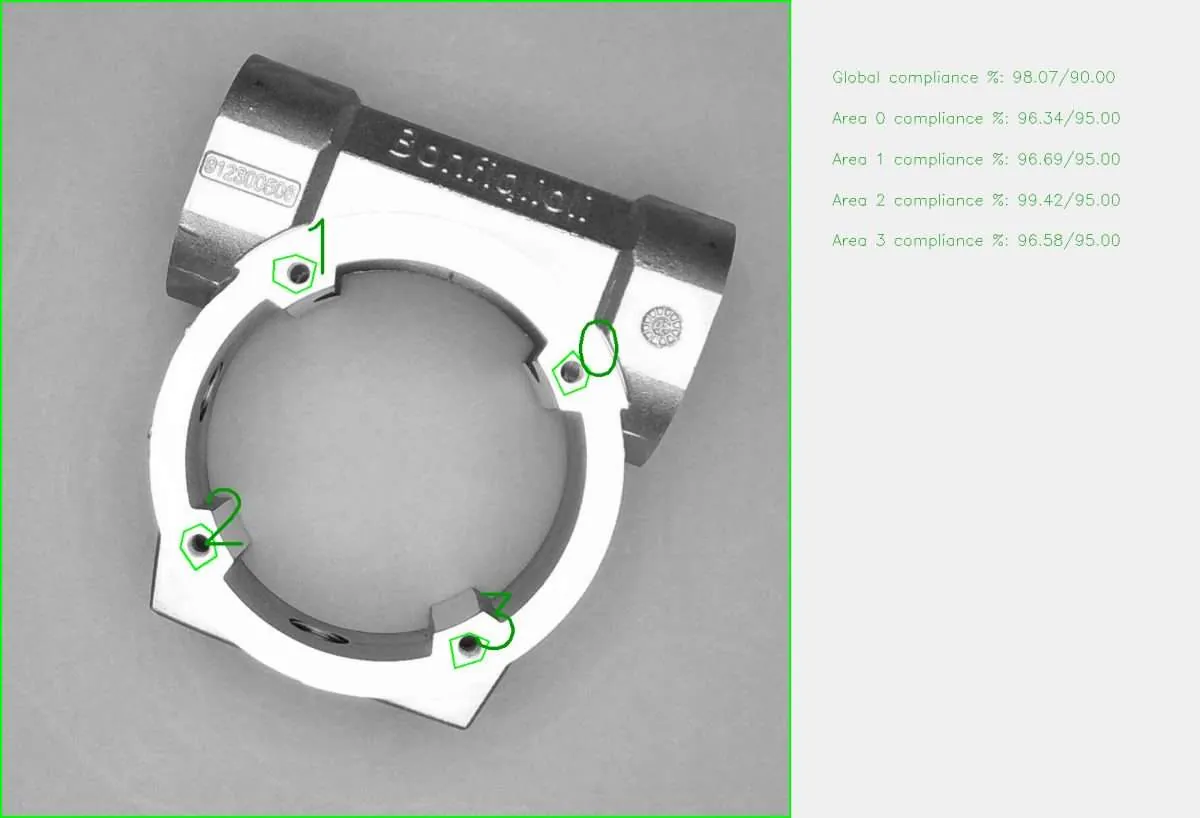
Key insight: La performance cala dal laboratorio alla fabbrica, ma il sistema impara continuamente dai nuovi dati e recupera la performance con il retraining regolare.
Limiti e Falsi Positivi
Nessun sistema di visione AI è perfetto al 100%. Ecco i limiti reali:
Falsi Positivi (Scarto un prodotto buono)
- Ombra sulla linea che somiglia a un graffio
- Sporco sulla lente camera
- Riflesso lucido che il modello interpreta come difetto
- Prodotto usato che somiglia a difetto ma è normal aging
Falsi Negativi (Lascio passare un difetto)
- Difetto microscopico (< 0.5mm) non catturato dalla camera
- Difetto sottile (es: micro-graffio appena visibile)
- Difetto in zona di ombra
- Tipo di difetto mai visto nel training (es: nuovo tipo di deformazione)
Soluzione:
- Falsi Positivi: Abbassare confidence threshold (da 95% a 85%)
- Falsi Negativi: Aumentare confidence threshold (da 85% a 95%)
- Nuovo tipo di difetto: Retrain con nuove immagini (2-4 ore)
Domande Frequenti
Altre domande? Chiamaci al +39 049 825 6850 o scrivi a info@logirobotix.com.
Quanto dura il training di un modello?
Quante immagini servono per trainare bene un modello?
Il modello continua a imparare durante la produzione?
E se il difetto è completamente nuovo?
Cosa succede se cambia l’illuminazione in fabbrica?
Un CNN può riconoscere difetti che non ha mai visto?
CNN vs Vision Transformer: cosa differenza?
Pronto a vederli in azione?
Articolo scritto da: Engineering Team Logirobotix
Ultimo aggiornamento: Agosto 2025
Risorse correlate: Sistemi di Visione AI • Blog
Provalo sulla tua linea. Prima di spendere un euro.
Mandaci 20 pezzi difettosi o foto ad alta risoluzione. Addestriamo un modello sui tuoi pezzi e ti mostriamo tasso di rilevamento, falsi positivi e tempo ciclo, prima che tu firmi qualcosa.
- pezzi o foto
- 20
- pezzi o foto
- giorni per i risultati
- 5-7
- giorni per i risultati
- nessun impegno
- €0
- nessun impegno
Si fidano di noi
Applicazioni correlate
- Soluzione
Controllo Qualità Ceramica Automatizzato
Mantieni lo standard artistico senza false positives. Distingui variazioni naturali da difetti reali. Riduci scarti del 65%, coerenza 100%, payback in 1-2 mesi.
Leggi - Soluzione
Software Visione Artificiale
Automatizza ispezionamento con AI vision. 100% copertura, zero errori umani, ROI 3-6 mesi. Packaging, farmaceutico, ceramica, Assembly, Industry 4.0.
Leggi - Soluzione
Visione Artificiale per Controllo Qualità Automatico
Ispezione 100% inline senza limiti di velocità. Elimina difetti, riduci rework fino al 60%, aumenta OEE di 5-12%. Zero configurazione manuale—l’AI impara dal tuo primo…
Leggi